学习笔记N-059
并发
- 更新
- 内容块
- 205
- 阅读
- 约 14 分钟
- 路径
- 学习笔记 / 操作系统/编译原理
程序/进程
进程~
程序在被运行时就会变成进程,进程并不只是在内存中的一串代码,它还包括了 CPU 状态,分配给进程的内存区域,已打开的文件列表以及 IO 设备等其他资源。进程不只是程序本身,而是程序包括其本身所需的运行环境
独立进程与协作进程
PCB:进程控制器
队列:进入队列的不是进程本身而是代表进程的进程控制器,因为进程本身是离散的它无法被当成一个一个元素进入队列
多核执行
cpu 标志位
CPU 分为用户模式和内核模式,我们在用户模式下会往计算机硬件内写入数据,但是 CPU 在用户模式下又不能直接操控硬件,这时候就需要操作系统代劳。
代劳的具体过程:系统调用(进程因为需要访问硬件,所进行系统调用向操作系统发送请求)
操作系统代劳的关键就是系统调用,这是一个精心设计的“受控跳转”:
- 1.触发:用户程序主动执行一条特殊指令(如 syscall),CPU被切换到内核模式。
- 2.审查:操作系统检查请求是否合法——文件是否打开、有无写入权限。
- 3.执行:操作系统调用硬盘或显示驱动,把数据真正写入硬件。
- 4.返回:操作系统把结果带回用户空间,CPU切回用户模式。
就是因为各个系统之间系统调用不一样,有些系统调用的代码在其他系统无法执行,所以 Windows 编译好的 .EXE文件无法在 Mac OS 上运行,即使二者拥有相同的 CPU
ABI:应用程序二进制接口——二进制代码各组件在特定操作系统特定架构下的交互方式
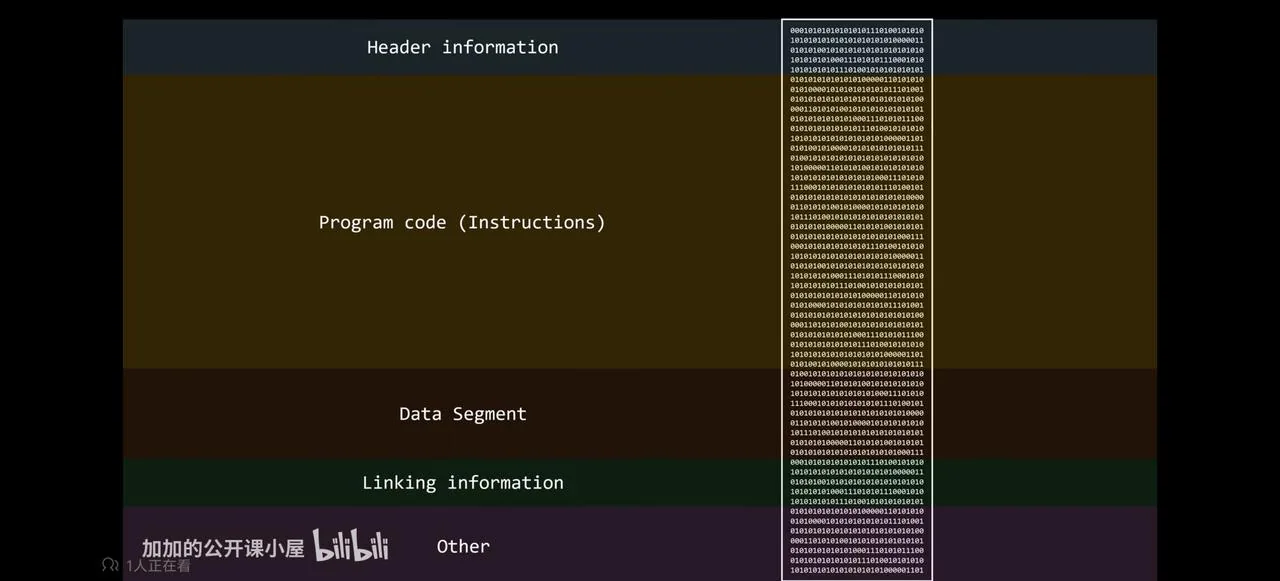
在这片零和一的海洋中程序的各部分都位于哪些位置(图中是一种可能),每个操作系统对此的规范都不一样,这种结构使得操作系统可以正确的加载并运行这个可执行文件
(ELF and PE)
IPC(进程与进程间通信):有时候进程和进程之间需要相互协作,就需要相互通信。下面是两种基本通信模型。
共享内存与消息传递Shader memory and message passing。
消息传递相比共享内存,可以使进程在不同的地址空间下进行交互。常用的消息传递机制包括管道,套接字,远程过程调用 pipes,Sockets remote procedure course
消息传递的机制实现是:有 A 和 B 两个进程,A 进程想和 B 进程进行连接,就要通过操作系统对二者进行通道的搭建(Operating system)将在二者之外的一块内存区域内创建一个邮箱(port端口),用来存放交换数据,邮箱的大小可以以动态调整,邮箱大小需要限制时采用异步通信代替同步通信或者采用缓冲队列。
为实现双端通信,可以创建双端队列,在邮箱中有单独的 a to b 通道和 b to a 通道.
A进程和 B进程都得通过操作系统提供的接口访问邮箱,而不能在自己的进程内直接访问邮箱的地址
两个进程之间不只有一条通道,还有的是只接受不发送的监听通道
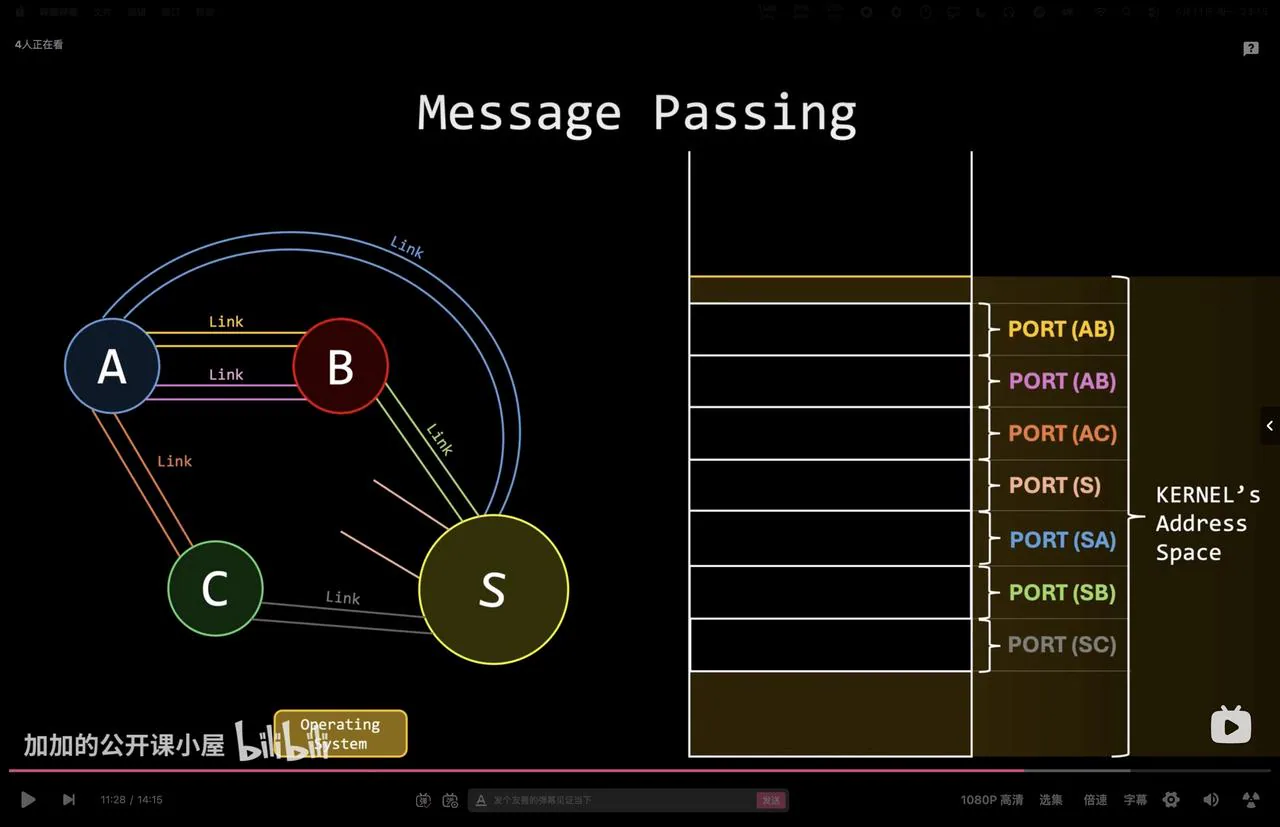
客户端-服务器架构
threads(线程)
一个调度系统可以使得 CPU 在这个进程执行IO操作时(大部分情况为从硬盘中读取数据),把 CPU 资源分给别的进程等来优化 CPU 对于进程的执行效率
因为默认进程与进程之间是可以并发进行的,所以可以对于每个请求单开一个进程,充分利用并发机制,优化效率。
但是这种做法对于单独开一个进程本身也是需要消耗时间的(1),进程如果过多,则内存使用效率低下(2),如果要同步全局状态,所有子进程都要保持同步以追踪状态的变化。
解决方法:对于单一进程进行改进,使得单一进程的代码支持并发操作
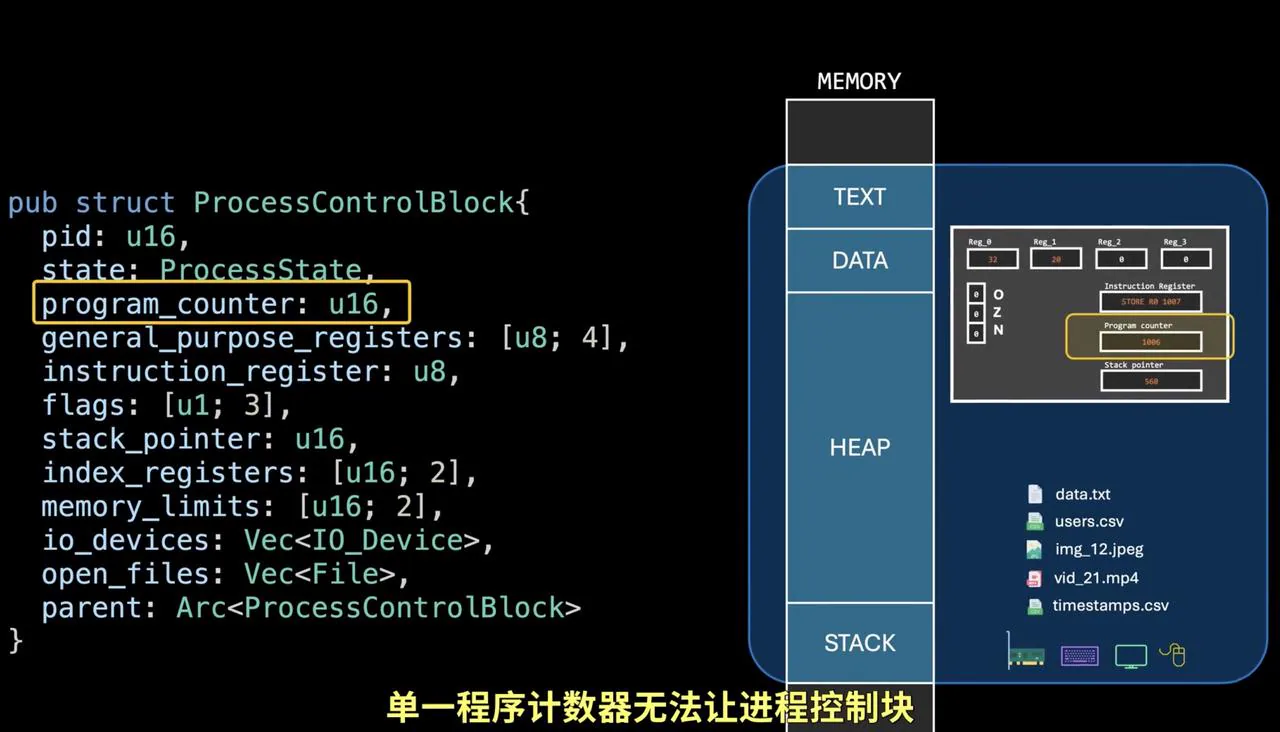
主要原因:单一程序计数器无法让进程控制块同步追踪多个任务(如下图)
将 CPU 中的单一 program counter(程序计数器)拆分为几个,分配给进程内每个需要并发执行的内部可执行实体,这些实体就是线程。(如下图 )
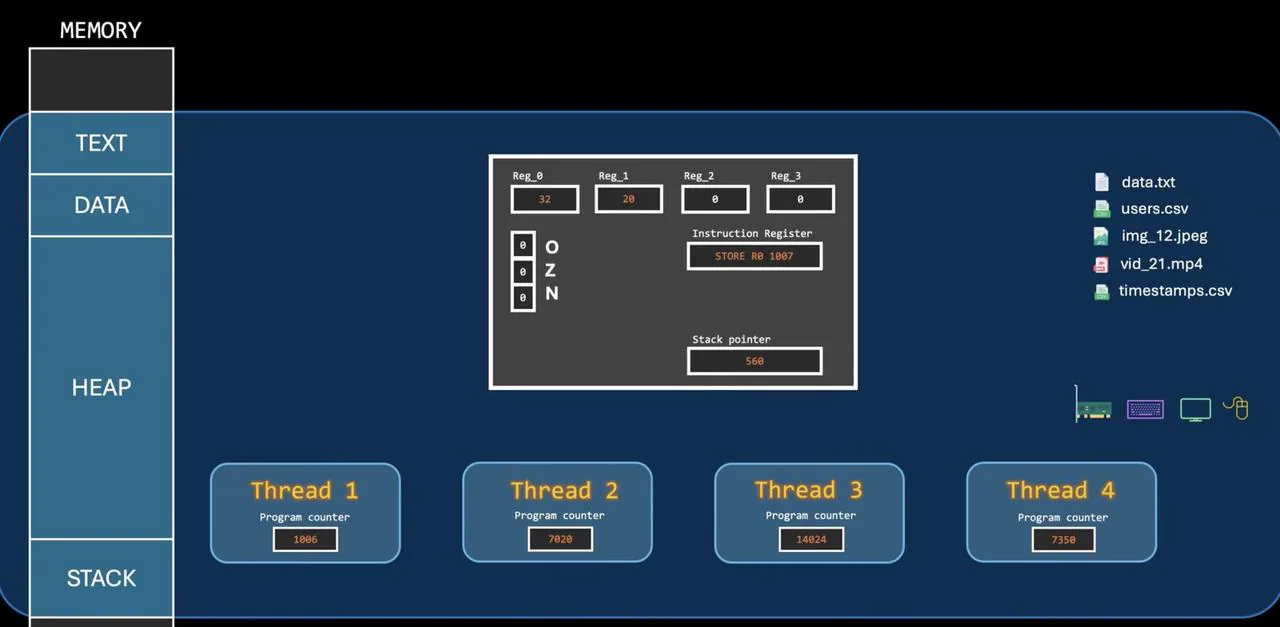
现在我们需要同一进程内的代码(如两个不同的函数)并发执行时只需要创建新的线程就可以了,而不需要创建新的进程。现在当某个线程在执行 i/o 阶段时,CPU 执行其他的线程就可以了。
(疑问点:在执行 I/O 阶段的时候,真的不需要 CPU 参与吗?在现代 CPU 和主板的架构中,CPU 基本不参与这个过程,CPU 只需在特定阶段给位于南桥中的 DMA发送指令让 DMA 来完成这个过程。配置阶段CPU 会参与,就是配置 DMA ;然后就是由 DMA 操控的传输阶段;最后是完成阶段CPU 进行中断)
线程在其本质上构成其独有的 CPU 状态,体现在线程也具有1.通用寄存器(Reg0~Reg3)2.程序计数器(PC)3.栈指针(SP)4.状态标志位(O/Z/N)5.线程私有栈等。
每个线程的 text,data,heap是相同的,但是 stack 空间是独立的(独立不代表无法访问)
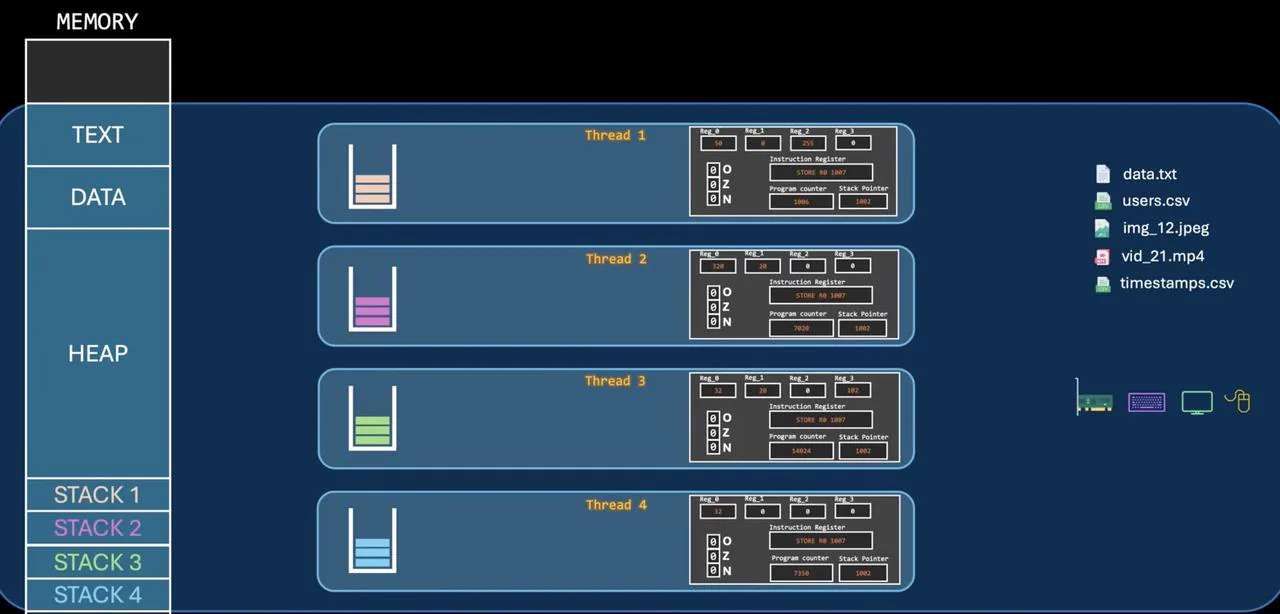
主线程和派生线程
主线程被终止时,其派生的线程即使正在工作也会被终止,整个进程就会终止创建一个新线程的性能开销远比创建一个新进程的性能开销小
线程所执行代码都位于内存中的文本段中,线程本身不包含代码,它通过程序计数器执行代码线程一般指向程序中的 text ,data 段,而不需要担心多个线程指向同一个内存区域时的危险,这两个区域永远不会被写入
在C语言中,无论是POSIX的 pthread_create 还是Windows的 CreateThread,创建线程时都需要传入一个函数指针。原因就在于操作系统调度线程时,必须知道从哪个内存地址开始取指令执行,而这个地址正是线程函数的入口点。
所以把程序划分到不同的线程中进行执行是由开发者自己编写和制定的,对于处理器在执行某个程序时的多线程优化,而不是 CPU 在执行程序时自己划分的
从操作系统来看,线程和进程一样都是最基本的可执行单位——从开发者的角度来看,线程是一种机制表示代码中特定的代码段可以并发执行
并发和并行
有 N 个核心最多同时执行 N 个线程
超线程技术:把一个核心分成两个虚拟核心,去执行两个线程,但并非翻倍的性能提升
数据并行与任务并行
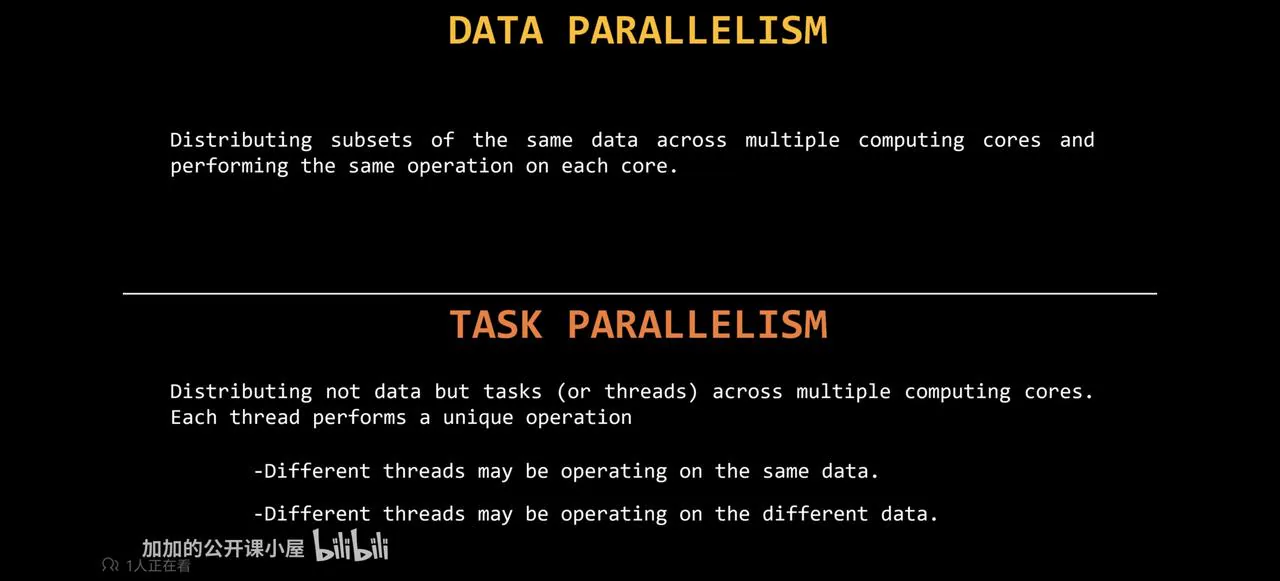
数据并行将庞大的数据拆成不同的子集,把不同的子集放在不同的核心上进行并行
任务并行指的是在一个大任务中可以分为很多小任务把小任务放在不同的核心上进行并行,就像一道题要同时求最大值最小值以及所有数的和就可以分配为三个任务在三个核心上进行执行(在四核处理器中,我用任务并行,把原本的大任务拆成四个小任务,但未必能获得4倍的性能提升)
上下文切换
中断:
软件触发中断&&主动请求操作系统分配资源 或 分给当前进程的定时器耗尽强制中断当前进程
为解决中断时cpu状态丢失的问题,除各操作系统特别的实现方法外有两种通用的实现方法:
1.处理器无需依赖单一寄存器组可以拥有多组寄存器组配置,不同的计算机组分配给不同的进程,这样当中断的时候直接切换下一个寄存器组,而并不需要覆盖当前寄存器状态
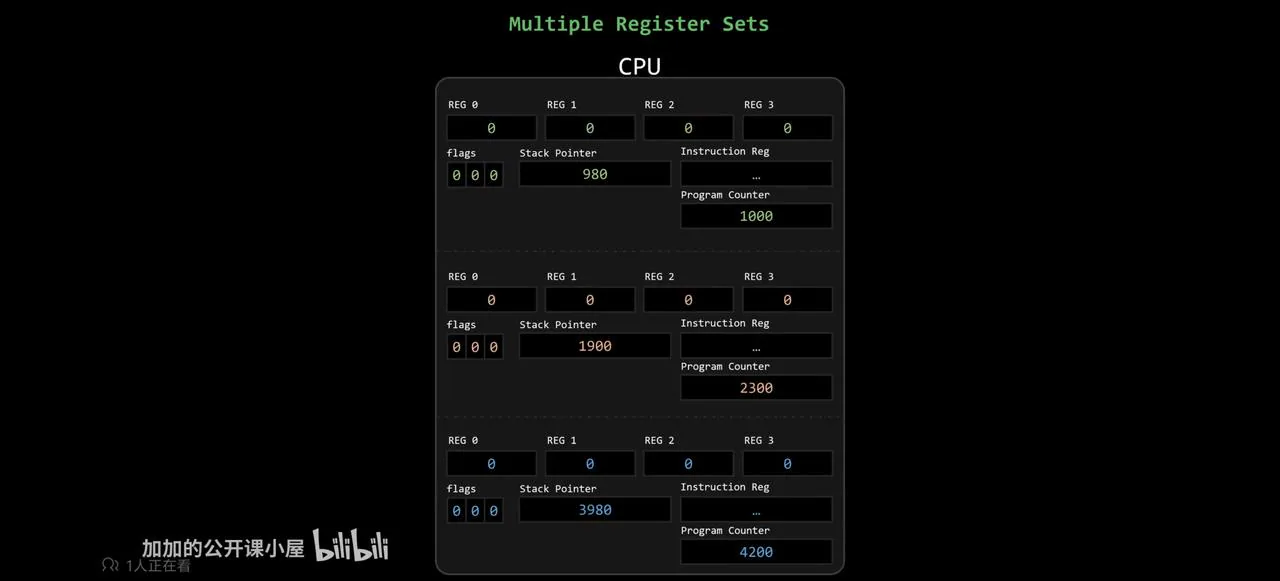
对于第一种方法难道有多少"应用"就要开多少寄存器组吗?不,寄存器组是硬件资源是有限的,一般两组寄存器组就够了一组为内核寄存器组一组为用户寄存器组。
2.一般使用两组寄存器——通用寄存器组和特权寄存器组(这种架构在现代 cpu 中不常见)
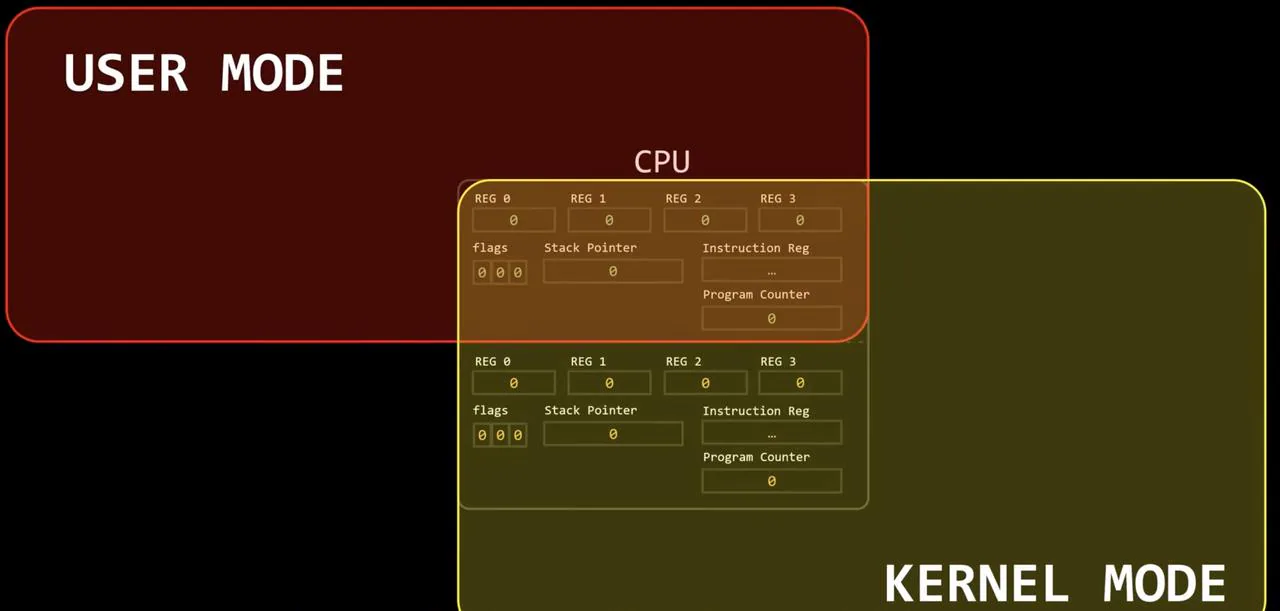
过程:
(1)中断发生,CPU 会停用通用寄存器组切换到特权寄存器组,确保被中断的进程状态保持不动。这样,中断就不会覆盖通用寄存器中的程序计数器,而是覆盖特权寄存器中的程序计数器
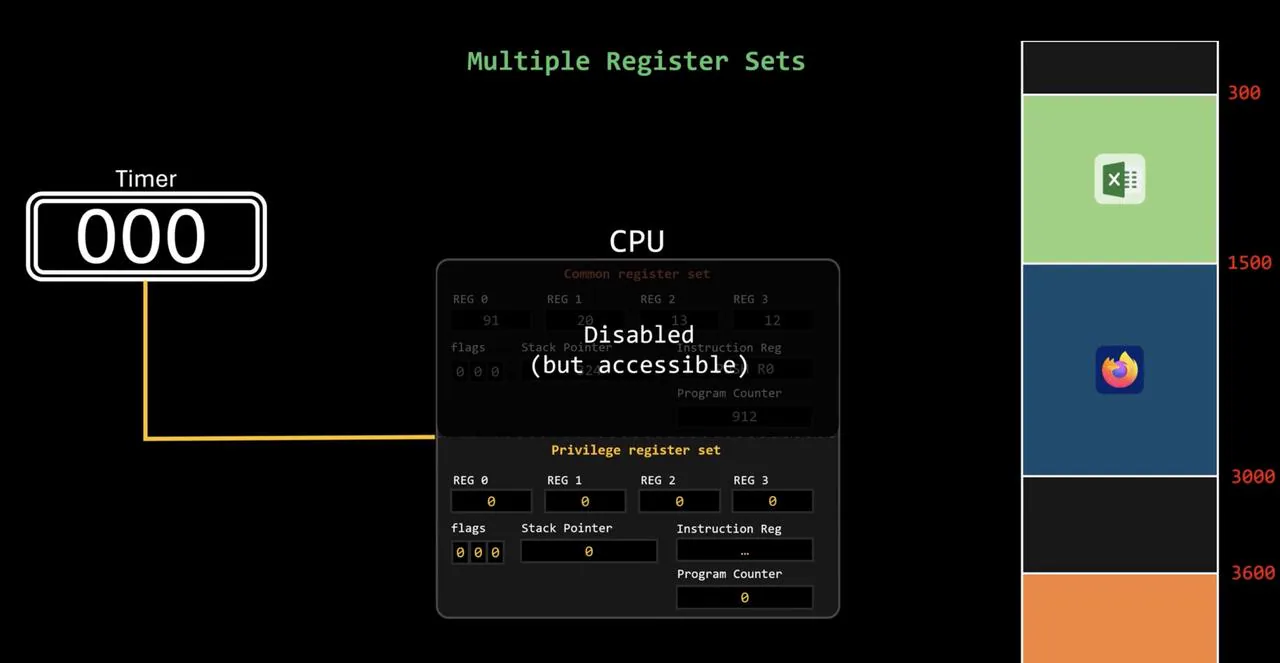
(2)通过特权指令操作系统可以访问被禁用的寄存器,并将其数值复制到当前启用的寄存器中。
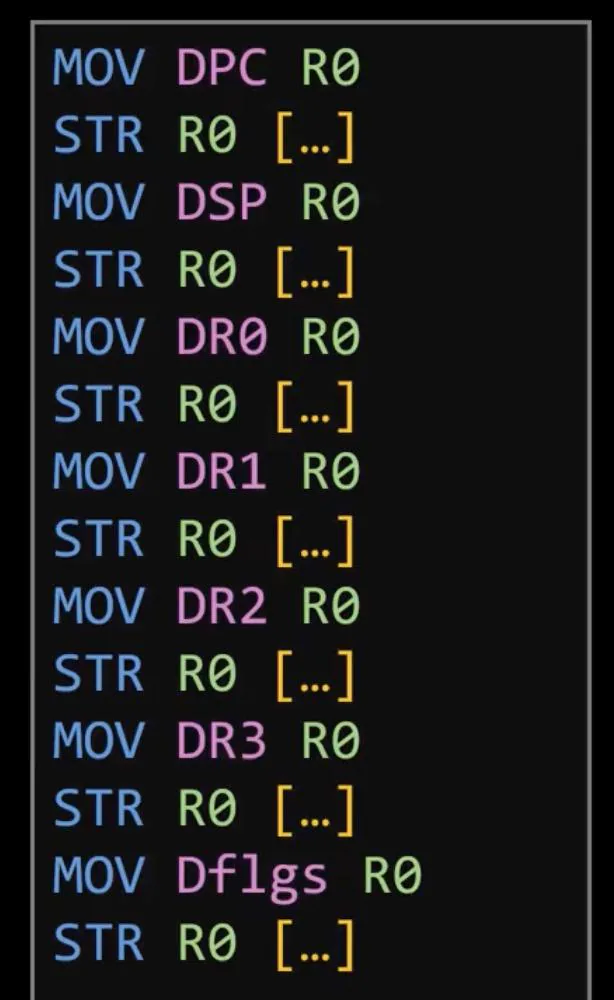
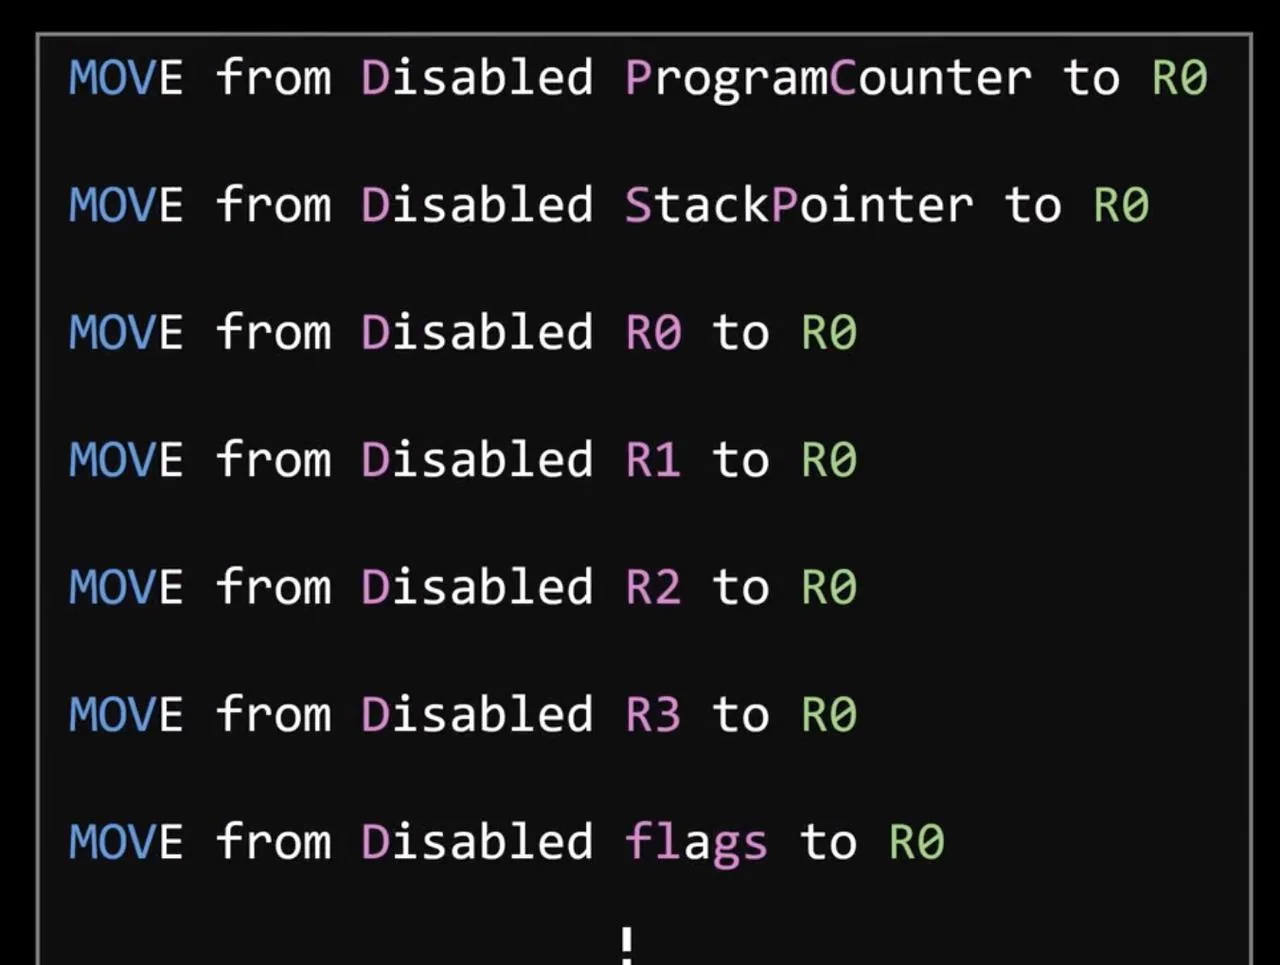
(3)每执行一次(2)中的指令后,就通过常规指令,将刚刚从禁用的寄存器提取的值存入内存位置
(4)最终,这些数据将被复制到被中断进程的进程控制块之中
(5)逆向,读取另一个 pcb,执行(1)(2)(3)(4)的逆向操作
然而这种架构在现代 cpu 中不常见,因为现代架构的 cpu 拥有数百个寄存器,还有SIMD寄存器等更复杂的组件
其他可行方案
硬件
P9让电脑更流畅(CPU 调度系统)
操作系统进程调度中五个关键评价指标
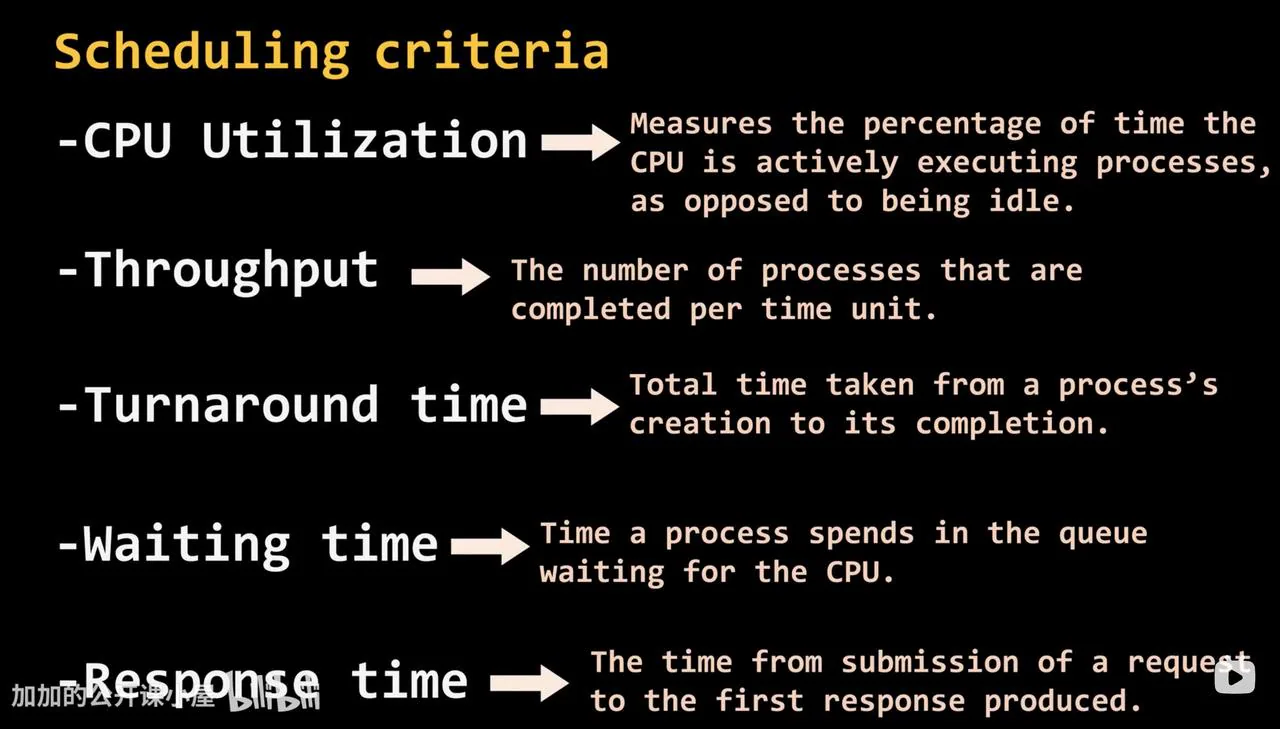
- 1.CPU 利用率(CPU Utilization)
- 2.吞吐量(Throughput)
- 3.周转时间(Turnaround time)
- 4.等待时间(Waiting time)
- 5.响应时间(Response time)
以下围绕以上 5 个优化点来优化
CPU 突发和 IO 突发:大量程序都存在大量的短时间 CPU 突发和少量的长时间 CPU 突发
I/O 操作不限于硬盘的输入和输出,等待用户按下按键,或者对于网络的访问都属于 I/O 操作的范畴
一般执行循环
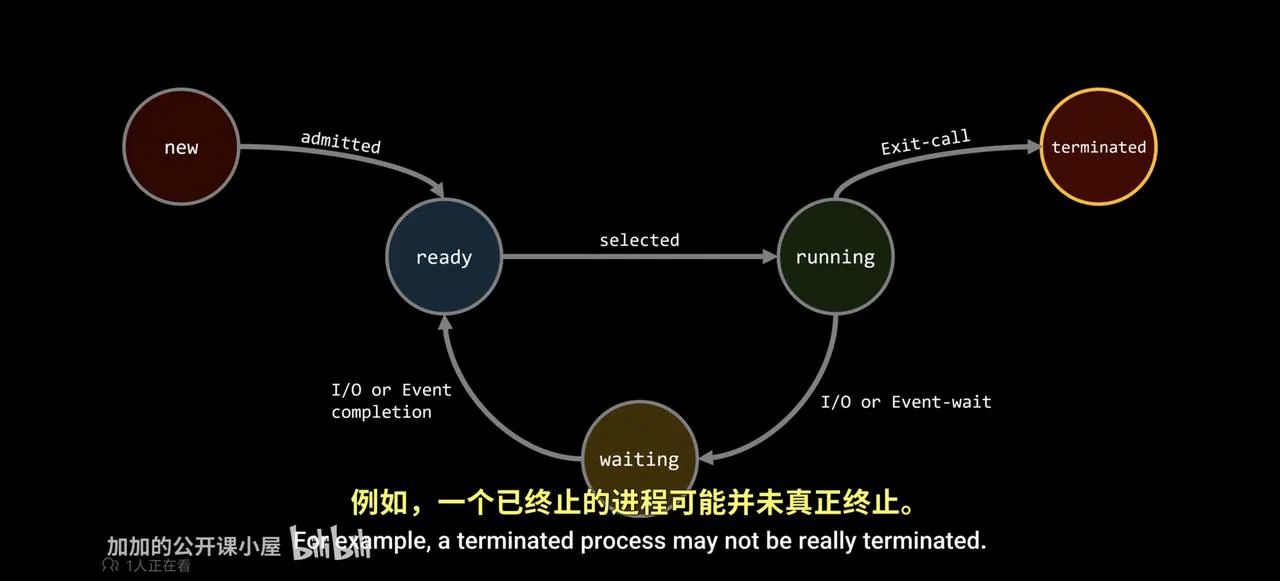
有些操作系统在终止一个程序的时候,会释放这个程序之前全部的分配资源,所以有些操作系统还会把这些程序分为已终止的和正在终止中的。
每个部分都是一个队列从而存放 PCB
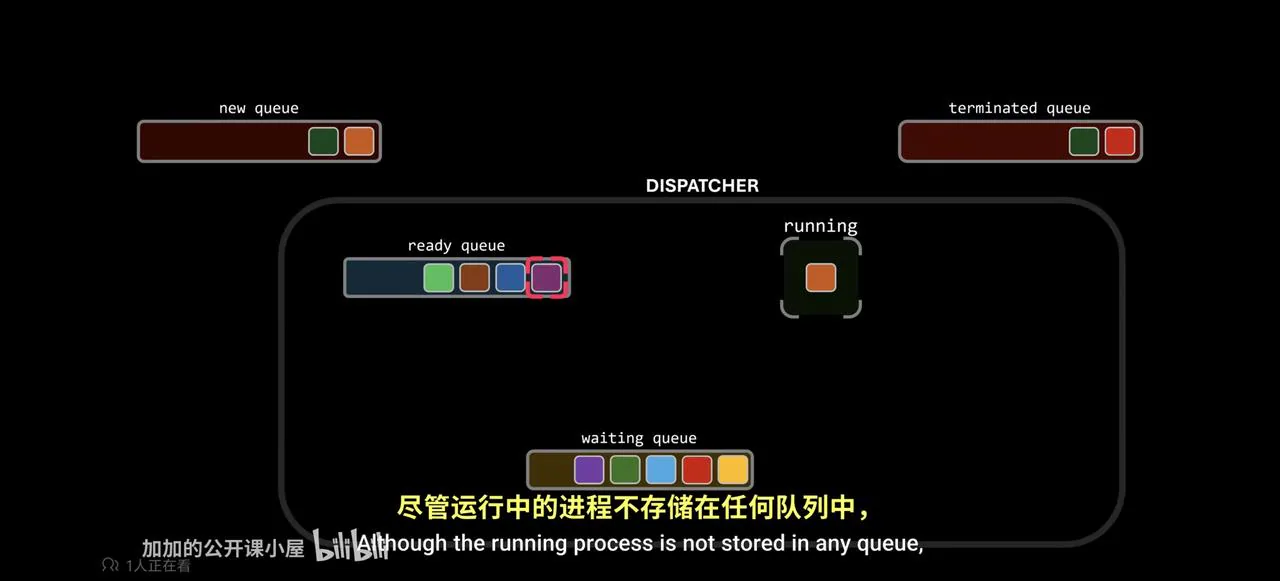
调度器将把一个进程移出 CPU 的核心并让下一个进程进入时,会把当前 CPU 状态在这个进程中存一份的。同样的在之前被中断的程序再次进入 CPU 核心时,会把之前存在 CPU 状态复制到 CPU 中,使得这个进程可以从之前的断点继续执行(如下图)
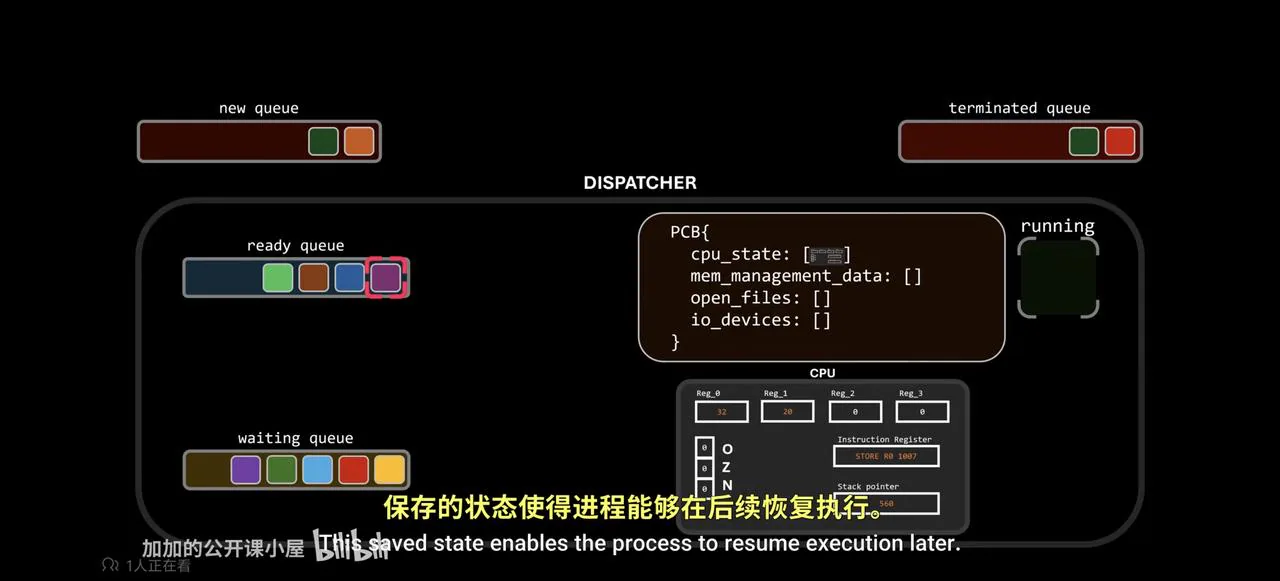
当然这个中断切换的过程也会产生延迟这几个就是 CPU 调度延迟
FIFO queue
Gantt chart
以上这种调度策略对于 I/O 密集型程序提升较大,但是长时间少次数的CPU 突发虽然占比较少但仍不为零,在某些程序中还有可能占到大部分。这种进程就不能像上文通过 I/O 优化获得更好的性能,单纯依靠 CPU 运算性能来提升速度,这种进程就叫 CPU 密集型进程
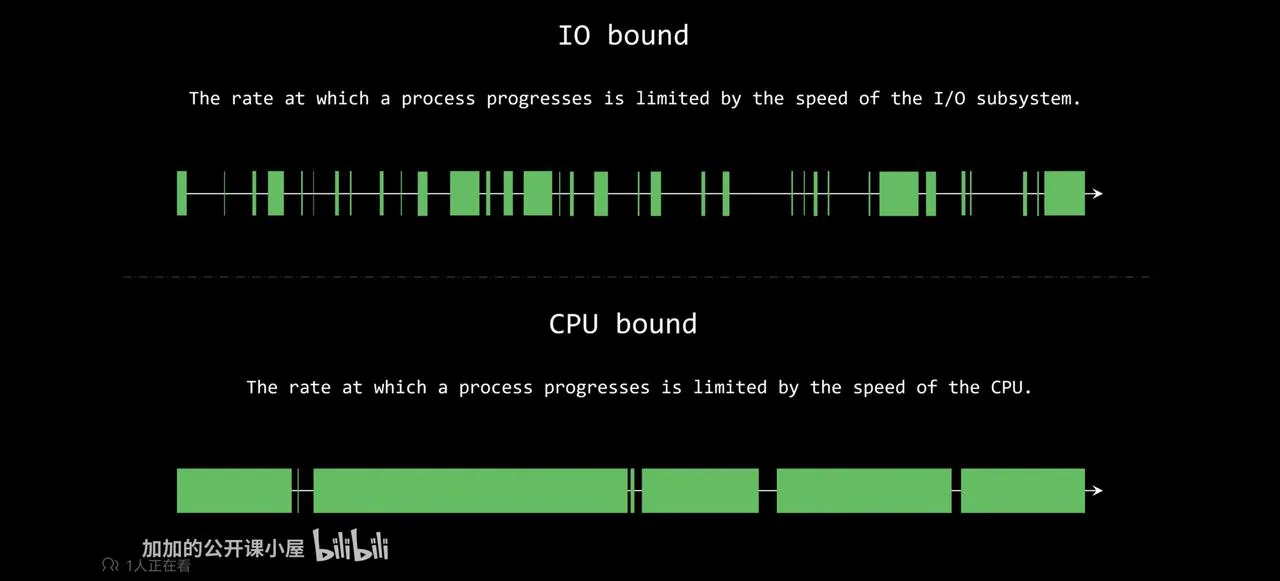
当一个进程中既有很多CPU 短的进程和 CPU 长的进程,如果这些 CPU 长的进程排在这些 CPU 短的进程前面,就会产生车队效应堵塞后面的 CPU 短的进程
最短作业优先算法(SJF)会将 CPU 分给下一个 CPU突发时间最短的进程。(最短下次 CPU 突发优先调度)(这个时长是可以预知的吗?不可以,这个时间是猜出来的,这也正是这个算法的缺陷)
最短作业优先算法使得 queue 不再严格遵循“先进先出”的规则,而是基于 long cpu-burst和 short cpu-burst动态调控的,这种算法能为给定进程集提供最小的等待时间。(如果有些 pcb 对应进程中有依赖关系,怎么解决先后问题?)(会不会导致其中一个 pcb 对应的进程一直无法被执行?进程饥饿,是一个缺陷)(对于 cpu 的每一个核心都有这一套系统吗,还是只有一套系统,去发给多个核心?)
最短作业优先算法的缺陷:未来的 cpu 突发时间不可预知
解决方法:根据这个进程以前的cpu 突发时间来预测
对于一个进程的 cpu 突发时间的预测时,有关其历史记录的搜索只和它自身的历史记录有关,和其他进程无关
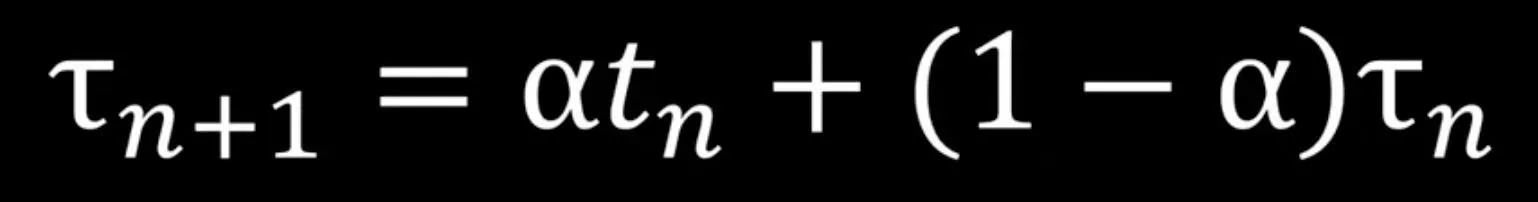
n:已经突发了 n 次,最近一次是 n,下一次是 n+1 次
τ:预测值
t:实际的执行时间
α:历史预测时间和当前实际时间的相对权重(当α为 0 时预测仅取决于历史记录;为 1 时仅取决于上一次的执行时间)
可依次展开为:
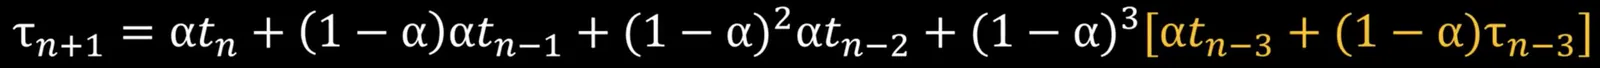
特殊情况:在进程刚建立时,不存在之前的突发结果,这时τ会被赋值一个系统的常量,这个常量通常取所有进程的 平均值。
抢占式调度算法和非抢占式调度算法:如果进程 a 在 cpu 核心中执行时,进程 b 已经来到了准备队列中。这时 b 的预测时长小于 a 的剩余时长,这时,需不需要中断 a 来运行 b。
Round Robin:时间片机制(计时器是物理设备,封装在 cpu 中)
最短作业优先算法中的预测中断时间和Round Robin 的时间片机制有关系吗?
答:无关,一个时长是来判断该进程进入 cpu 核心的顺序的,一个是来限制进程在 cpu 核心中的运行时间的
如果一个进程是因为时间片耗尽和被抢占所导致的中断,则不会进入等待队列等待I/O操作,而是直接进入准备队列
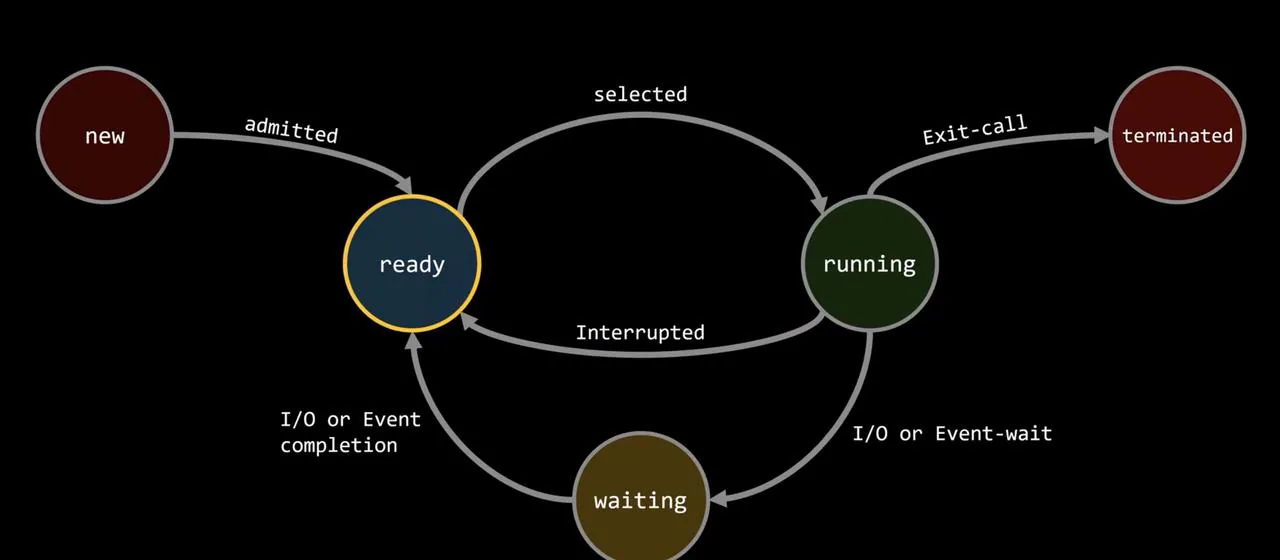
这就使得,某个进程不会因为被一直抢占 cpu 时间而造成的饥饿。最坏的情况下,也可以在一个固定的时间下被执行
时间片过大:算法退化为基础的队列;时间片过小:中断开销,上下文开销大。
cpu 的并发的原理就是在每次只能执行一个进程的物理限制下,通过中断等手段,让 cpu 在多个进程中快速切换,制造出多个进程同时进行的假象。但是如果进程数量过多,cpu 核心频率不够的情况下,速度变慢,就无法制造出“并发”的假象了,需要一种算法来优化。(不同进程所需要的时间片是不同的,可以不为所有进程分配相同时间片)
解决办法:识别哪些进程对于用户和操作系统更为重要(优先),优先保障系统的运行和用户的体验。
优先级调度(Priority Scheduling):
使用优先队列实现(priority queue),和之前的队列一样,但是额外给每个队列中的进程增加了编号(优先级顺序),在 ready queue 中,按照这个优先级插队执行进程。
学过C++STL的人可以发现,对于队列中优先级最高的进程的每次搜索的复杂度都是O(n),怎么优化?
一般创建多个队列,把优先级不同的进程放在不同的队列中,把优先级相同的放在相同的队列中。
为防止某个队列饥饿,在各个队列中进行轮转调度算法,为每个队列分配时间片,在各个队列中依次执行,而不是一直执行一个优先级高的队列中的进程
优先级调度也存在饥饿现象(相同的,最短作业算法是优先级算法的一种)
解决方法:如果一个低优先级的进程在一段时间内一直被高优先级的进程插队,那么就提升一级这个进程的优先级
在实际运用中,多种算法可以组合使用,比如组合优先级调度(Priority Scheduling)和Round Robin实现优先和公平的兼顾。
在多级队列中还有
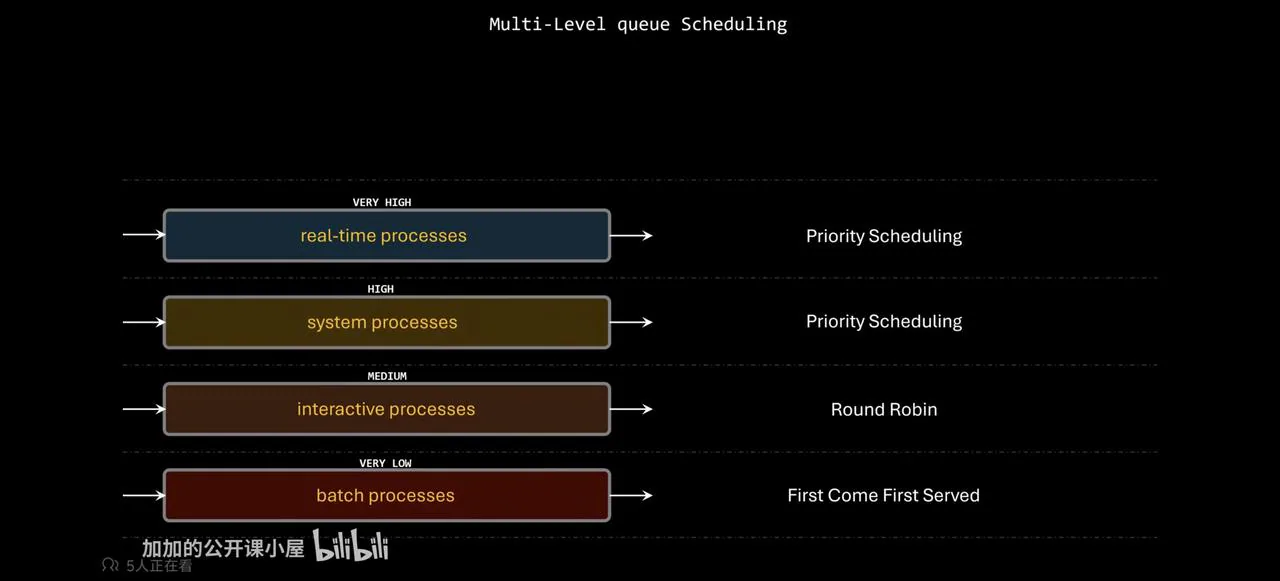
可以为不同队列再使用不同的算法
根据用户使用方法的不同,基于对cpu实现更加智能的调度算法的期待,诞生的多级反馈队列算法
多级反馈队列算法(Multi-Level feedback queue Scheduling )
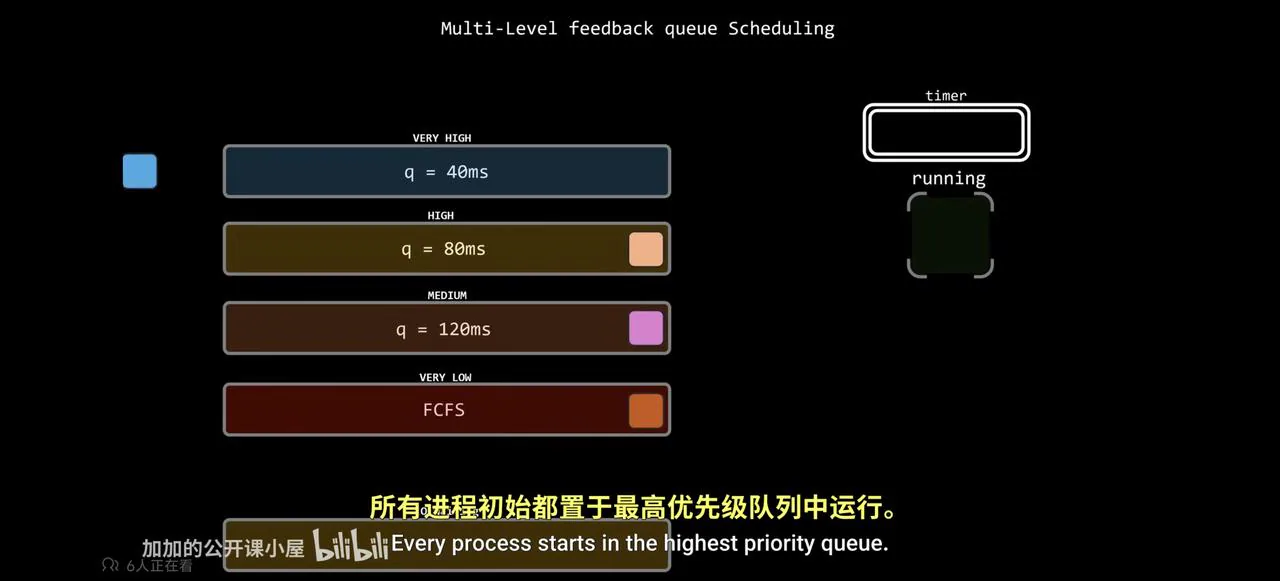
目的:这种算法在不选择预知该进程是 CPU 密集型还是 I/O 密集型的情况下,同时满足交互式进程的快速响应和长批处理进程(作业)的需求。
原理:初始状态下所有进程位于最高优先级的队列,为所有进程分配时间片,执行最高队列中的进程。如果这个进程在时间线以内就可以执行完的话就返回他原来所在的队列,如果没能执行完的话就返回他下一个优先级的队列;如果在本次执行中执行完进程时未耗尽时间片,将返回他更高一级优先级的队列。
更低优先级的队列拥有更长的时间片。
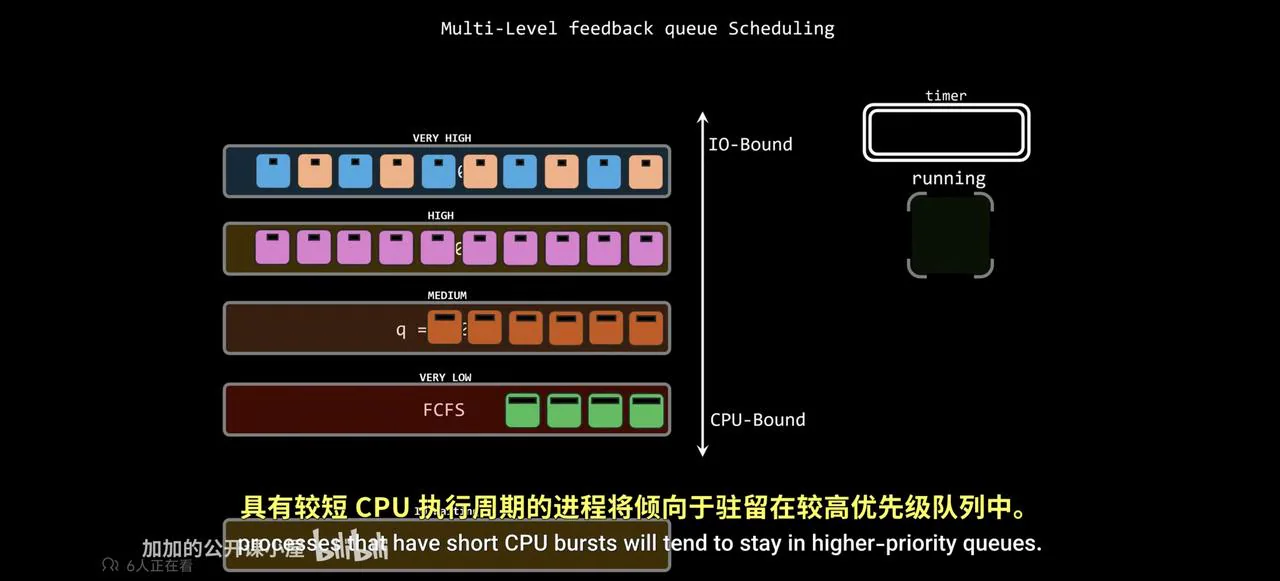
在此介绍的是MLFQ的一种实现方法,它存在很多的变体。(主要区别在于对于每个队列的不同算法选择,进程在队列中优先级变化的规则)(例如在优先级调整中,可以不根据当时有没有超出时间片来决定,而是基于历史的平均值来判断。为了避免突发值影响的不必要的队列突变)
问题1:
Multi-Level feedback queue Scheduling中,所需时间较长的进程呢,会被放到更低优先级的队列,被更低优先的执行,很明显,这个进程是 CPU 密集型进程。难道如果一个进程是cpu有密集性进程,就要对它进行惩罚吗?如果用户现在要用的主程序,就是压力大的cpu benchmark,那么就因为调度算法我们也测量不出准确的数据;一个 CPU 密集型的游戏进程也会卡顿。这与我们最初的设计背道而驰。现代操作系统是怎么解决这种办法的?
问题2:
空闲时,任务管理器中通常有上百个进程,但 CPU 占有率却只有10% ,为什么?这难道说明在高优先级队列中基本没有进程?大量进程都其实在优先级低的队列中?如果真的是这样,那么在低优先级队列中的进程也没有那么坏了。
问题3:
即使后台运行了 cpu benchmark,cpu 占用率直接到了 100%,为什么我的前台进程还可以响应,不卡顿?
问题4:
在同一 cpu 的不同操作系统的电脑上,运行同一 benchmark(问:软件一般对硬件进行优化,有对操作系统进行优化的吗)跑分相同还是不同?同一电脑不同后台进程,或在 bench 时执行不同操作(拉出新的前台进程),benchmark 的结果不一样?大差不差吗
总结:
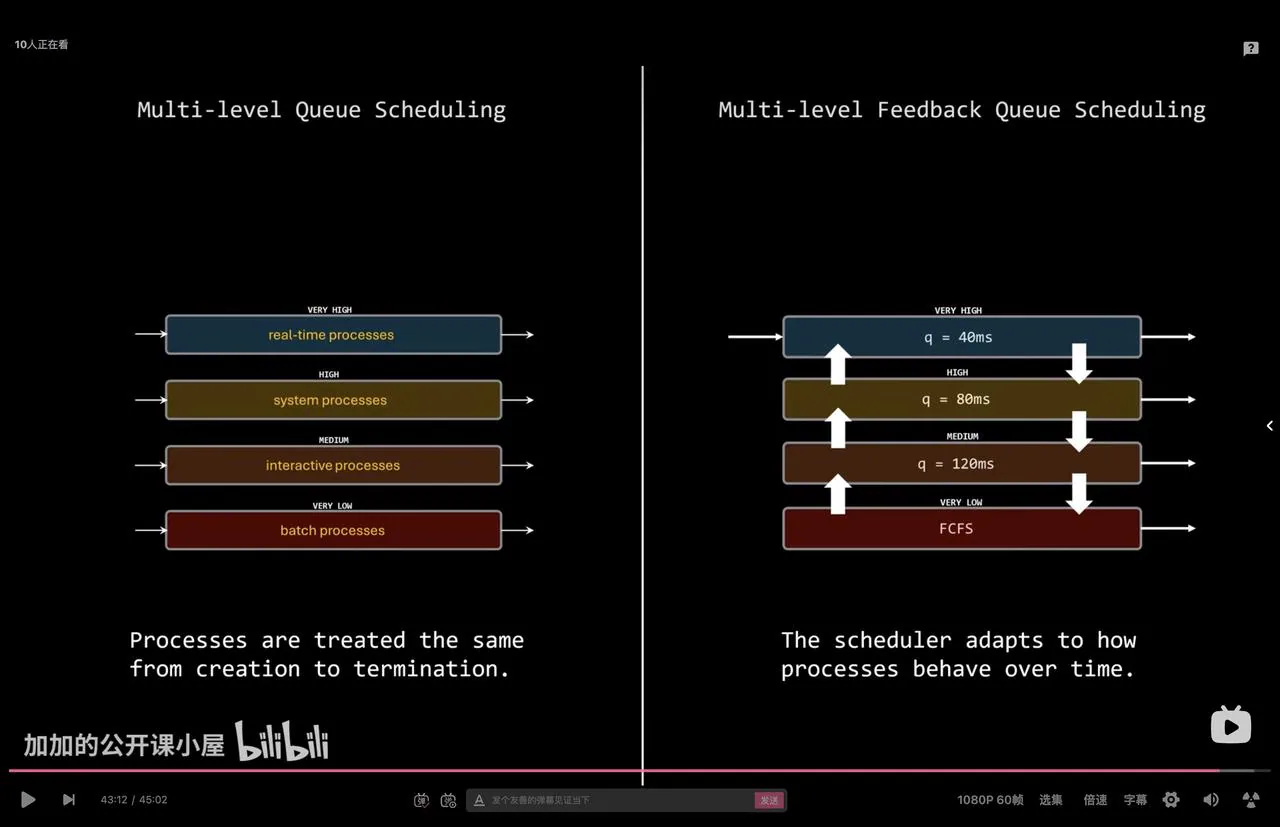
多级队列和多级反馈队列
现代操作系统为应对 cpu 技术的进步,多硬件的协同,诞生了更为复杂的调度策略。
Multicore CPU
Multithreaded cores
NUMA systems
Power efficiency constraints
Load balancing requirements
10.并发实体的交互
Race Conditions(竞态条件 )
Most operations are not atomic
并发和并行:
- •并发(Concurrency)是逻辑上的同时发生,是一种结构设计能力。
- •并行(Parallelism)是物理上的同时发生,是一种硬件执行状态。
原子操作(Atomic Operation)是指不可被中断的一个或一系列操作。它要么全部执行完成,要么完全不执行,不会在执行到一半时被调度机制(如线程切换、硬件中断)打断。
情景2: 一个任务被分为多个线程,多个线程同时向一个计数器(变量)中写入
寻找在 1 到 n 中的质数,每个线程负责一个区间的循环,同时向一个 sum 中去累加发现质数的次数。
对于 sum++的操作不是原子的,如果有两个线程在某一时刻都判断其所在区间的一个数为质数,同时访问了 sum 此时 sum 应该分别加一,但是因为是同时的,所以他们读取到的 sum 的原始值一样,自增的值也一样,返回的 sum 也一样,所以结果是相比原来少加了一。(情况之一:在读取和返回时冲突)
情景3:(对于情景 2,假设不让这几个线程并发,就可以解决问题吗)有五个线程同时找到了质数,cpu将分别计算他们并返回内存中的 sum,如果 cpu 在计算自增之后,把 sum++后的值返回内存中去时被中断了,这次自增运算就失败了。
问题:对于没有执行完的线程,执行一圈后在继续执行不就可以弥补了吗?
答:错,cpu 在断点继续开始执行时,基于的不是内存中的值,而是 cpu 被中断时的快照,cpu 快照中记录的 sum 会覆盖内存中的 sum,这次 cpu 当然可以完成这次之前没有完成的自增运算,但是也无效了剩下四次计算的结果。
结果:在不同计算机状态下,多次运行同一程序,得到的结果不一样。
Peterson 算法