学习笔记N-038
搜索
- 更新
- 内容块
- 155
- 阅读
- 约 11 分钟
- 路径
- 学习笔记 / C++ / C++算法
前置知识(图,DFS,BFS)在数据结构中
状态是点
状态转移是边
搜索
何时用
例子1
迷宫问题
Leet code 1926
概括:判断坐标是否为终点(一层循环)->寻找下面可能为终点的坐标(一层循环)->累计步数
三种方法"累计步数" 的时机和方式不同罢了
(可以综合着几种方法的注释一块看)
1.将步数的和状态一起记录
int n = maze.size();    // n = 迷宫的行数(二维数组的元素个数)
int m = maze[0].size(); // m = 迷宫的列数(第一行的元素个数)class Solution {
vector<pair<int, int>> dir = {{-1, 0}, {1, 0}, {0, 1}, {0, -1}};
public:
int nearestExit(vector<vector<char>>& maze, vector<int>& entrance) {
int n = maze.size(), m = maze[0].size();
auto visited = vector(n, vector(m, 0));
int sx = entrance[0], sy = entrance[1]; //起点
visited[sx][sy] = 1;
queue<tuple<int, int, int>> que; //起点的位置和步数
que.emplace(sx, sy, 0);
while (!que.empty()) {
auto [x, y, step] = que.front();
que.pop();
if (x != sx || y != sy) { //只要和起点的行或者列不同,就不是起点
if (x == 0 || x == n - 1 || y == 0 || y == m - 1) return step;
}
for (auto [dx, dy] : dir) { //遍历检查四个方向
int nx = x + dx, ny = y + dy;
if (nx < 0 || nx >= n || ny < 0 || ny >= m) continue; //不能越界
if (maze[nx][ny] == '+') continue; //不能有墙
if (visited[nx][ny]) continue; //不能被走过,路径最短
visited[nx][ny] = true;
que.emplace(nx, ny, step + 1);
}
}
return -1;
}
};- 1.为什么用队列:BFS需要用到队列,先进先出,先发现的先处理,一层层外扩
- 2.第 17 行为什么可以遍历四个方向:
因为有方向向量数组和第 18 行,可以在每次循环时加上不同的值
vector<pair<int, int>> dir = {{-1, 0}, {1, 0}, {0, 1}, {0, -1}};2.是否被访问过的数组记录步数
class Solution {
    vector<pair<int, int>> dir = {{-1, 0}, {1, 0}, {0, 1}, {0, -1}};
public:
    int nearestExit(vector<vector<char>>& maze, vector<int>& entrance) {
        int n = maze.size(), m = maze[0].size();
        auto min_dist = vector(n, vector(m, INT_MAX));        //记录每个位置到入口的最短距离
        int sx = entrance[0], sy = entrance[1];
        min_dist[sx][sy] = 0;        //入口到自己的距离为 0
        queue<pair<int, int>> que;
        que.emplace(sx, sy);        //把起点放在队列中

        while (!que.empty()) {
            auto [x, y] = que.front();
            que.pop();

            int step = min_dist[x][y];
            if (x != sx || y != sy) {
                if (x == 0 || x == n - 1 || y == 0 || y == m - 1) return step;//判断当前是否在边界上,因为出口在边界上(非入口的,在边界上的位置)
            }

            for (auto [dx, dy] : dir) {
                int nx = x + dx, ny = y + dy;
                if (nx < 0 || nx >= n || ny < 0 || ny >= m) continue;
                if (maze[nx][ny] == '+') continue;
                if (min_dist[nx][ny] <= step + 1) continue;    //不符合条件的都跳过了,所以队列中任何时刻,存在的是当前合法的坐标

                min_dist[nx][ny] = step + 1;
                que.emplace(nx, ny);        //把当前点放在队列中
            }
        }

        return -1;
    }
};3.一层一层遍历
更像图一点BFS
class Solution {
    vector<pair<int, int>> dir = {{-1, 0}, {1, 0}, {0, 1}, {0, -1}};
public:
    int nearestExit(vector<vector<char>>& maze, vector<int>& entrance) {
        int n = maze.size(), m = maze[0].size();
        auto visited = vector(n, vector(m, 0));
        int sx = entrance[0], sy = entrance[1];
        visited[sx][sy] = 1;
        queue<pair<int, int>> que;
        que.emplace(sx, sy);

        int step = 0;
        while (!que.empty()) {
            // 获取当前层的节点总数
            int cnt = que.size();    //这时 que 中的数据都是要处理的坐标(每次都要)
            // 一次性处理完当前层的所有节点
            while (cnt--) {
                auto [x, y] = que.front();
                que.pop();        //首元素被记录之后 pop 出去

                // 出口判断:不是入口且在边界上
                if (x != sx || y != sy) {
                    if (x == 0 || x == n - 1 || y == 0 || y == m - 1) return step;
                }

                // 遍历四个方向
                for (auto [dx, dy] : dir) {
                    int nx = x + dx, ny = y + dy;
                    // 三重合法性检查
                    if (nx < 0 || nx >= n || ny < 0 || ny >= m) continue;
                    if (maze[nx][ny] == '+') continue;
                    if (visited[nx][ny]) continue;

                    // 标记已访问并入队
                    visited[nx][ny] = true;
                    que.emplace(nx, ny);
                }
            }
            // 处理完一整层后,步数加1
            step++;
        }

        // 所有可达节点都处理完仍未找到出口
        return -1;
    }
};
中间那层循环while (cnt--)没有增加任何额外的迭代,只是把之前统一的迭代又进行了分组,我认为逻辑是更加明确了
区别:
- 1.处理步数的方法不同
- 2.队列中存储的内容不同
- 3.空间复杂度不同
例子 2
迷宫 again(hdoj 1072)
(x,y,k)在(x,y)处还有 k 倒计时
m*n*k
auto bfs = [&]() {
    auto visited = vector(n, vector(m, vector(7, 0)));
    queue<tuple<int, int, int, int>> q;        //tuple 可以有任意数量的元素,不是只能 3 个;还可以定义结构体或者嵌套 pair
    q.emplace(sx, sy, 6, 0);
    visited[sx][sy][6] = 1;

    while (!q.empty()) {
        auto [x, y, k, step] = q.front();
        q.pop();

        if (maze[x][y] == 3) return step;
        if (k == 1) continue;

        for (auto [dx, dy] : dir) {
            int nx = x + dx, ny = y + dy;
            if (!inside(nx, ny)) continue;
            if (maze[nx][ny] == 0) continue;

            int nextk = k - 1;
            if (maze[nx][ny] == 4) nextk = 6;

            if (visited[nx][ny][nextk]) continue;
            visited[nx][ny][nextk] = 1;
            q.emplace(nx, ny, nextk, step + 1);
        }
    }

    return -1;
};- 1.不能直接写
queue<int, int, int, int>,这是语法错误。queue是模板类,只能接受一个类型参数,不能直接写多个类型。
- 2.题中规定了maze[x][y] == 3;maze[nx][ny] == 4和maze[nx][ny] == 0的情况,所以简化了很多的步骤。
例子 3
泛洪
Leetcode 200
从一个状态出发,把所有符合条件的状态都标记
include <vector>
using namespace std;
class Solution {
vector<pair<int, int>> dir = {{-1, 0}, {1, 0}, {0, 1}, {0, -1}};
public:
int numIslands(vector<vector<char>>& grid) {
int n = grid.size(), m = grid[0].size();
auto inside = [&](int x, int y) {
return x >= 0 && x < n && y >= 0 && y < m;
};
auto dfs = [&](auto &self, int x, int y) -> void {
for (auto [dx, dy] : dir) {
int nx = x + dx, ny = y + dy;
if (!inside(nx, ny)) continue;
if (grid[nx][ny] == '0') continue;
grid[nx][ny] = '0';
self(self, nx, ny);
}
};
int cnt = 0;
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (grid[i][j] == '1') {
grid[i][j] = '0';
dfs(dfs, i, j); //递归
cnt++;
}
}
}
return cnt;
}
};include <bits/stdc++.h> // 万能头文件,包含所有标准库
using namespace std;
// @lcpr-template-end
remark | includeTemplates // 这两行是LeetCode模板注释,无实际作用
// @lc code=start
class Solution {
public:
int numIslands(vector<vector<char>>& grid) {
int n = grid.size(), m = grid[0].size(); // n=行数,m=列数
int cnt = 0; // 岛屿计数器
// 定义递归DFS的lambda表达式(C++14+ 泛型lambda递归写法)
auto dfs = [&](auto &self, int x, int y) {
// 【终止条件1】:越界直接返回
if (x < 0 || x >= n || y < 0 || y >= m) return;
// 【终止条件2】:不是未访问的陆地('1')直接返回
if (grid[x][y] != '1') return;
// 标记当前陆地为已访问(用'#'代替,避免重复遍历)
grid[x][y] = '#';
// 递归遍历上下左右四个方向
self(self, x - 1, y); // 上
self(self, x + 1, y); // 下
self(self, x, y - 1); // 左
self(self, x, y + 1); // 右
};
// 遍历整个网格
for (int i = 0; i < n; i++) {
for (int j = 0; j < m; j++) {
if (grid[i][j] == '1') {
cnt++; // 发现新岛屿,计数器+1
dfs(dfs, i, j); // DFS遍历整个连通分量
}
}
}
return cnt;
}
};- 1.标记代表不会被重复统计,每标记一个cnt++
- 2.有点像回溯,但是只回退递归函数,不回退状态(没有尝试后发现不行的pop_back())
- 3.前面那种用队列、一圈圈扩散的是 BFS;现在这段用递归、一条路走到黑的是 DFS
最短路(单源)
之前的例子 1,2,3 在广度搜索之后直接返回了结果(步数),因为边权是一样的,所以直接就是最优解,现在要在边权不一样的情况下寻找最优解
min_dist[x] = 起点0到节点x的最短距离,初始全赋值为INF
auto min_dist = vector(n, INT_MAX);
queue<int> q;
q.push(0);
min_dist[0] = 0;
while (!q.empty()) {
    int u = q.front();
    q.pop();
    if (u == target) return min_dist[u];
    for (auto [v, c] : graph[u]) {
        if (min_dist[v] > min_dist[u] + c) {
            min_dist[v] = min_dist[u] + c;
            q.push(v);
        }
    }
}
return min_dist[target];松弛操作
min_dist[u] + c < min_dist[v]Bellman-Ford
n 是图的总顶点数量
min_dist[0] = 0;//设置起点
for (int i = 0; i < n; i++) {
    for (auto [u, v, c] : edges) { // 采用第一种边的存储方式,起点,终点,边权
        if (min_dist[u] == INF) continue;
        if (min_dist[u] + c < min_dist[v]) {
            min_dist[v] = min_dist[u] + c;
        }
    }
}
return min_dist[target];第前 n-1 轮遍历,找到最短路
和第 n 轮遍历,检测负权环
一个点被更新了 N 次后依然还能被松弛,说明存在负环
设置累加数,或者设置标记位
Dijkstra
前提:没有负环
每次优先选取队列中距离起点最近的点,这个距离一定是你起点到该点的最大距离
堆,优先队列
// 在 bfs 的基础上用优先队列改进
auto min_dist = vector(n, INT_MAX);
auto calced = vector(n, 0);
using pii = pair<int, int>; // <dis, u>
priority_queue<pii, vector<pii>, greater<int>> q;//小顶堆
q.emplace(0, 0);
min_dist[0] = 0;
while (!q.empty()) {
    auto [dis, u] = q.top();
    q.pop();
    if (calced[u]) continue; // 一个点可能会在队列中多次, 但只应该被计算一次, 避免被重复计算
    calced[u] = true;
    if (u == target) return min_dist[u];
    for (auto [v, c] : graph[u]) {
        if (min_dist[v] > dis + c) {
            min_dist[v] = dis + c;
            q.emplace(min_dist[v], v);
        }w
    }
}
return -1; // 无法到达目标点
都需要什么:
- 1.graph存边
- 2.一个优先队列进行比较
- 3.min_dist存最短路
- 4.calced存是否被判断
priority_queue的初始化:每一位都是pair<int, int>,底层用vector<pii>实现,用greater<int>比较,实现小顶堆
对于:
auto [dis, u] = q.top();有
C++语法中第4点
依托于优先队列,直接找到了起点到某一点的最短路
比较规则:
先比较pair的第一个元素(距离dis),值小的排在堆顶
如果第一个元素相等,再比较第二个元素(节点编号u),编号小的排在前面
一般用在搜索算法中,权值状态比较多的时候(一步与一步之间不是 step++,而是一个比较复杂的“代价统计”)
和回溯的区别
相同:都可以对图进行操作
搜索不需要回滚状态
回溯:路径影响最终状态,路径不一样,所到达的同一个终点也是两种不同的结果
搜索:终点被搜索过了,就不走第二条路搜索了
做题
找状态
确定状态间如何转移
确定 O (状态 * 转移) 复杂度在可接受范围内
无边权 -> bfs
有边权 -> Dijkstra
做题之后写的
- 1.min_dist和queue开一样的两位或三位
- 2.噩梦那道题需要额外记一个倒计时,可以看成他在一个长为n,宽为m,高为7的正方体里面行走
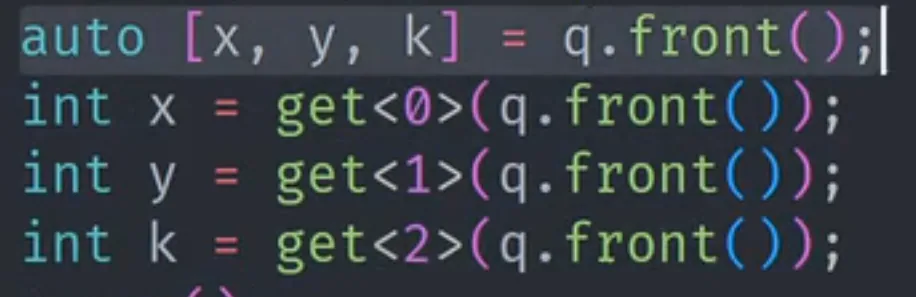
- 3.结构化绑定,两种写法,注意c++17之前的限制(如上图)
- 4.迷宫类题:
判断是否到达出口位置(在边上,在指定位置上)
是否超出迷宫
当前min_dist <=step + 1时continue;剩下的更新值
- 5.泛洪题:
当上下左右都找不到相邻的土地的时候,为一次递归的终结
第一步:全局扫描,寻找 "种子点"
第二步:深度优先,穷尽整块区域
第三步:逐层递归,完成整块标记
第四步:回到全局扫描,寻找下一个种子点
- 6.P4779单源最短路的模板
基于边集数组和邻接表的两种存边的方法
在上面的写法中,解包出来的dist没有被用到,但是也可以理解为只有当dist == min_dist[u]的时候,代码才会执行到松弛操作。
和上面的单源最短路有一些不同,这个是找s到其他所有的最短